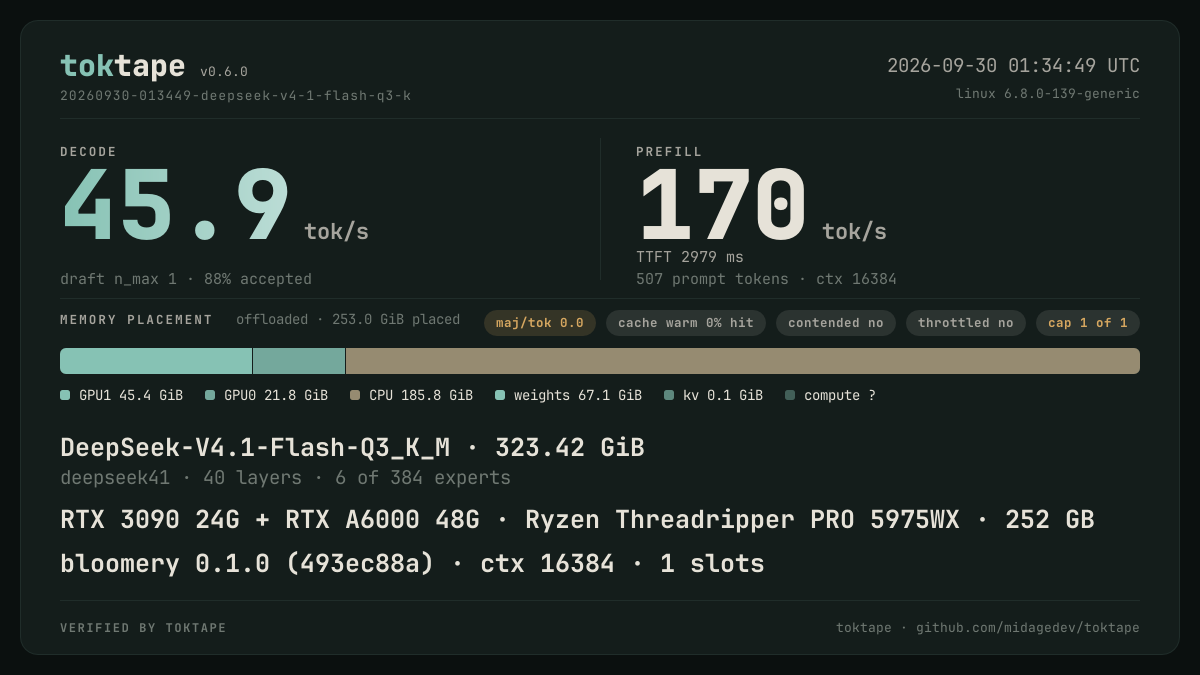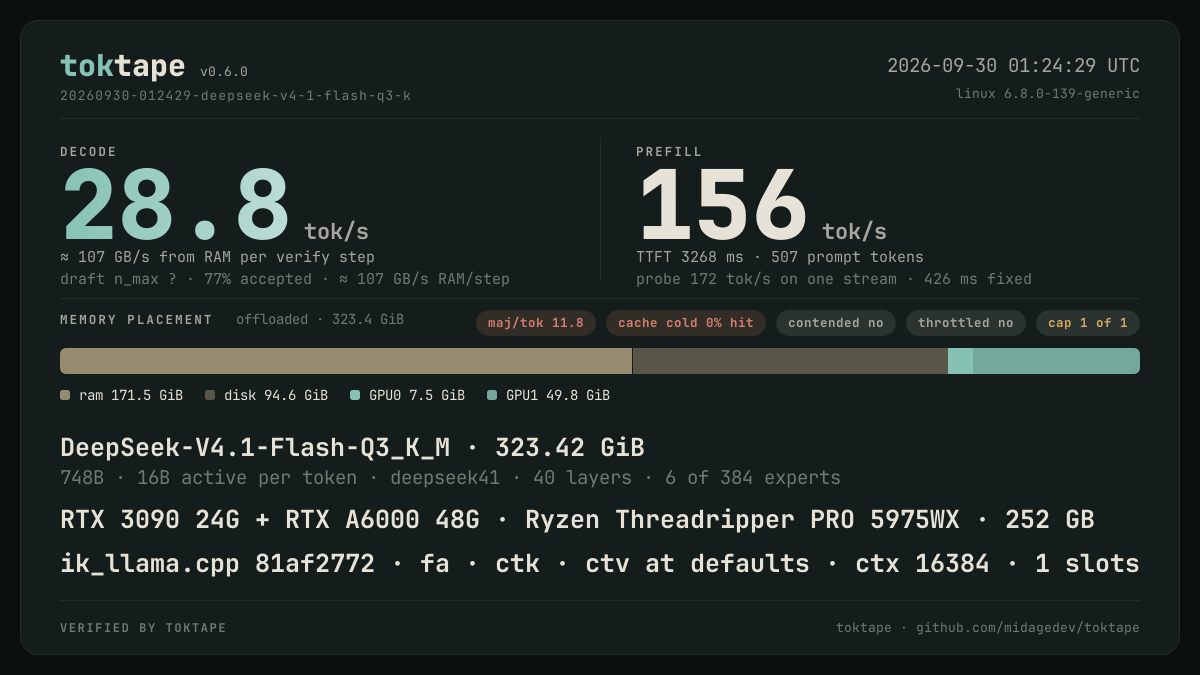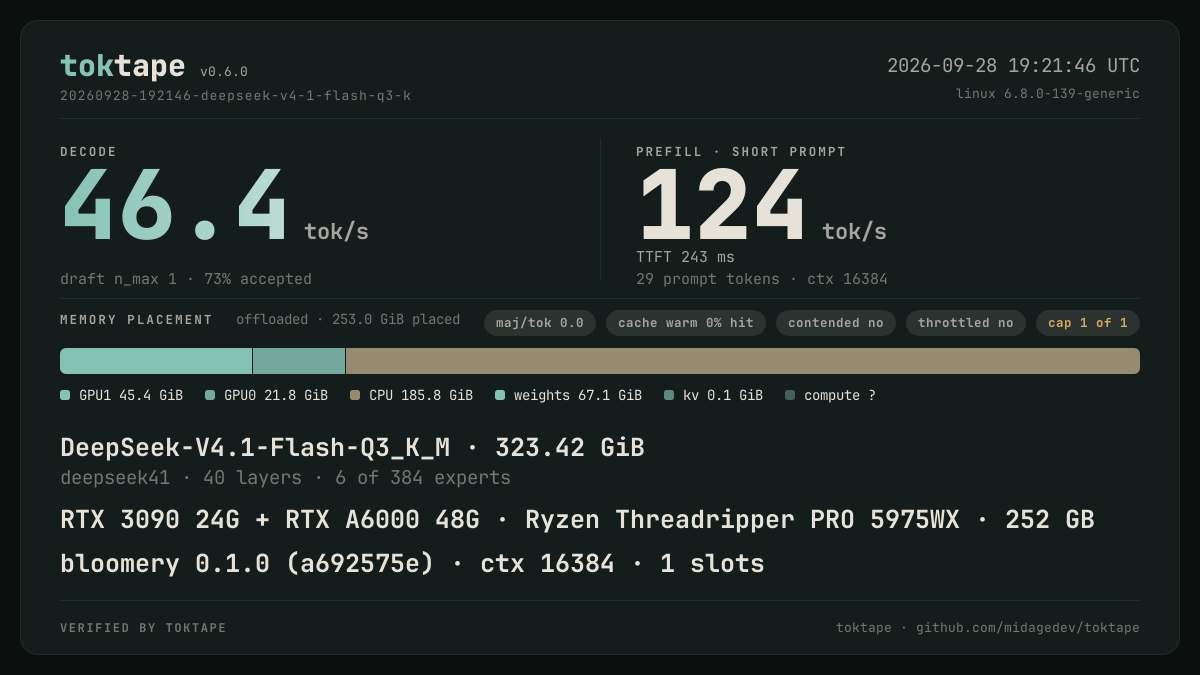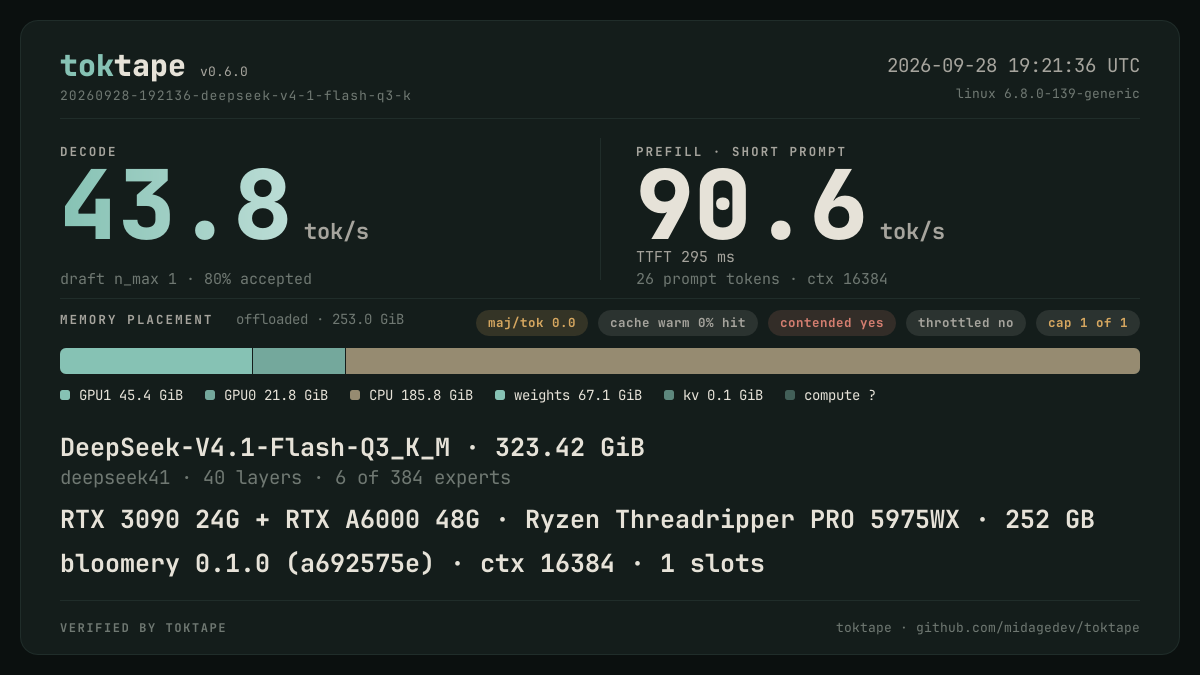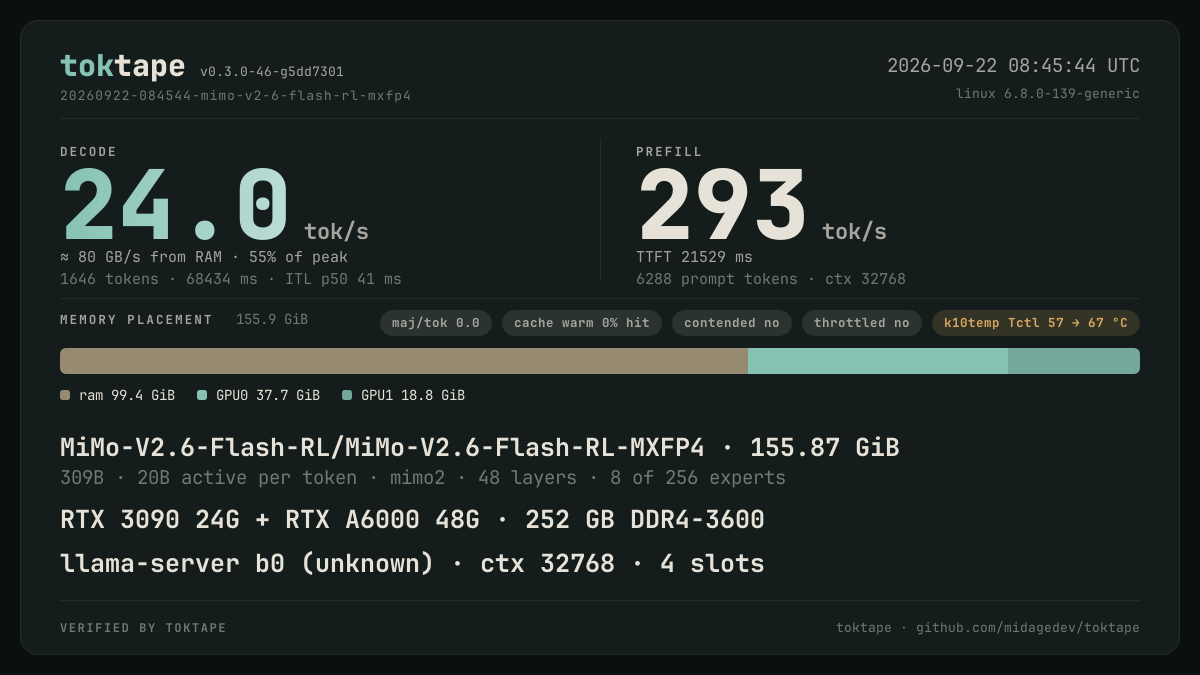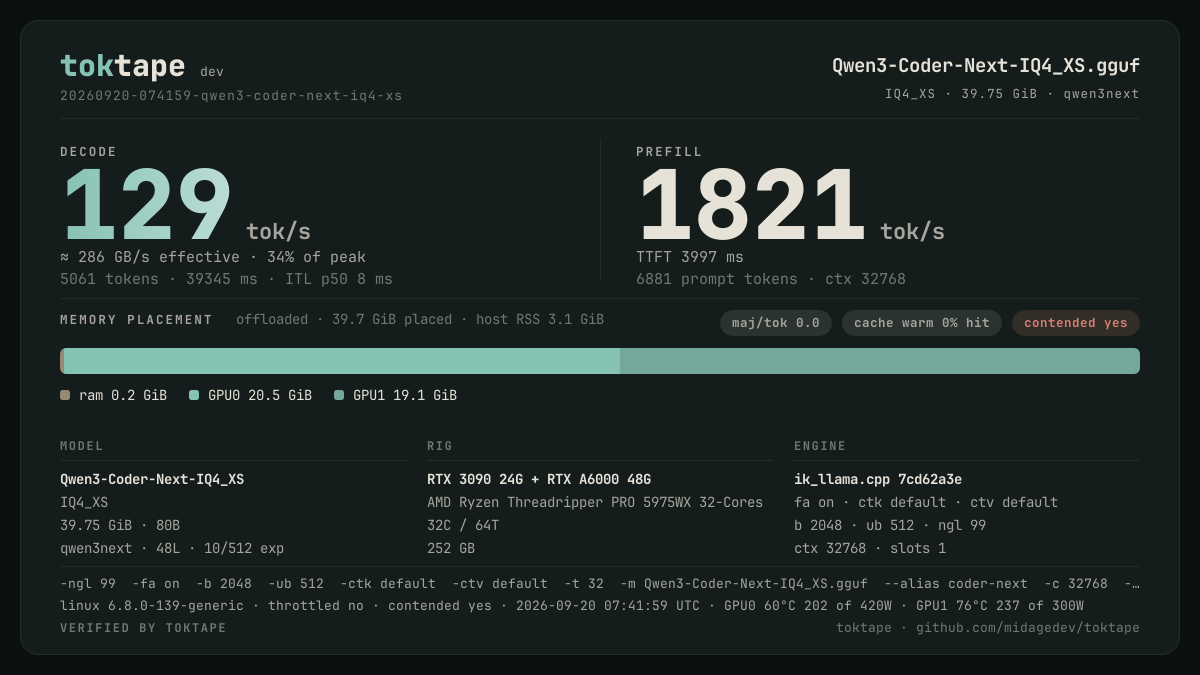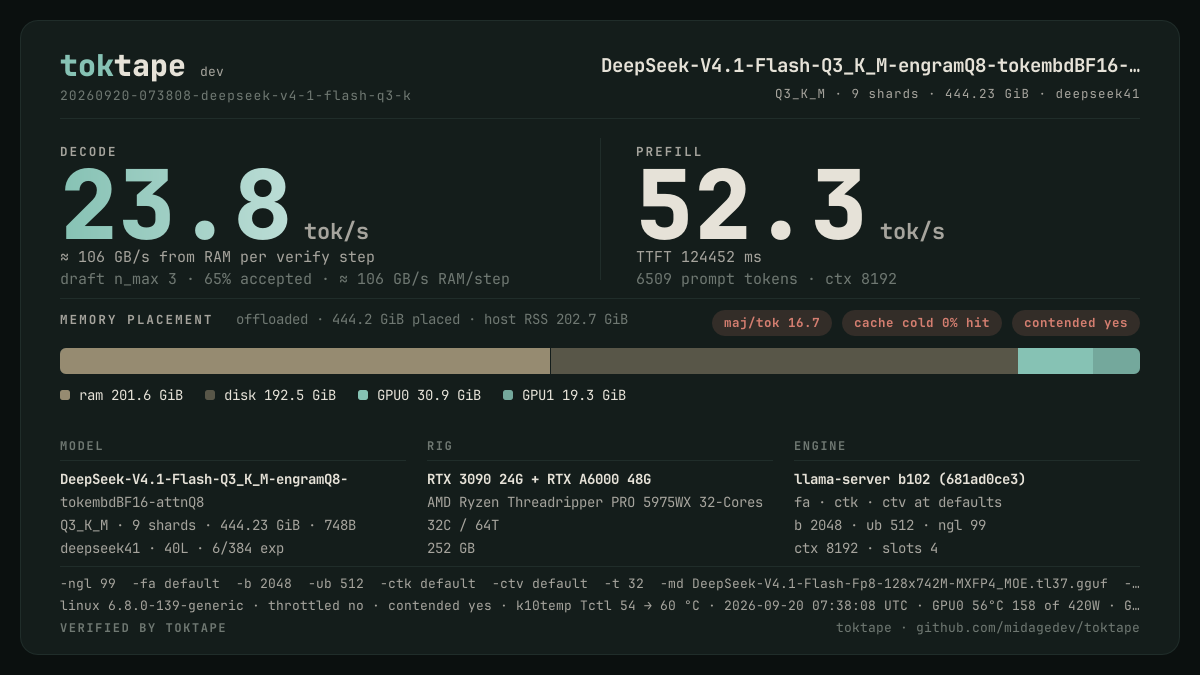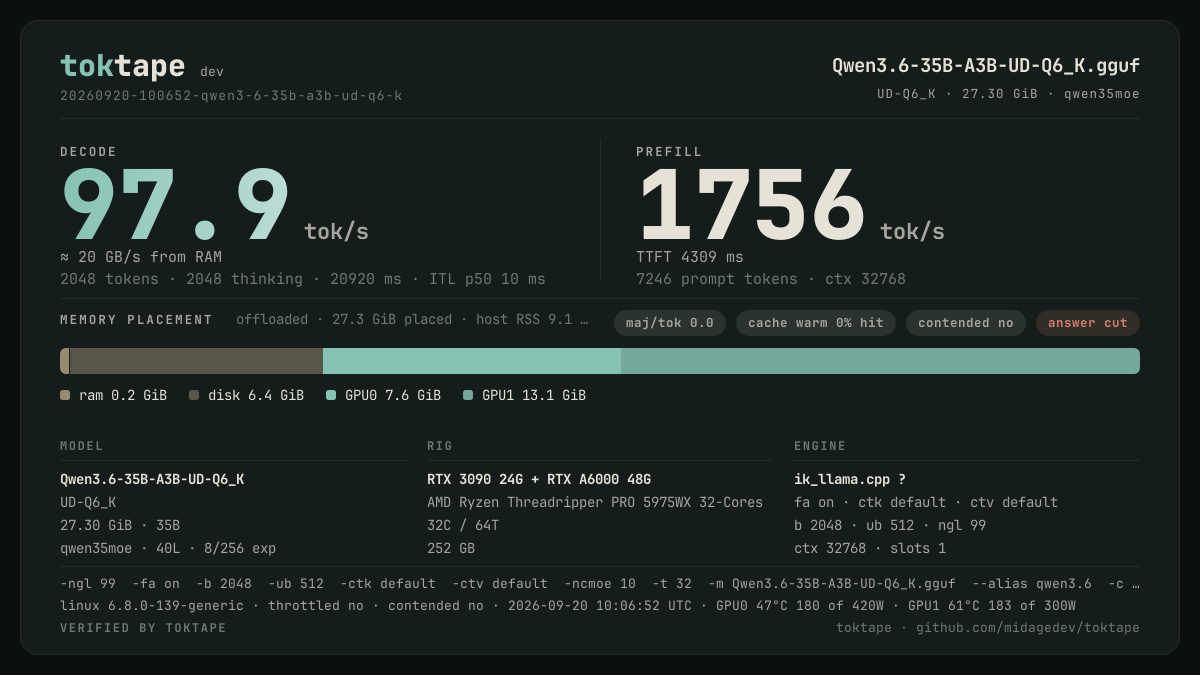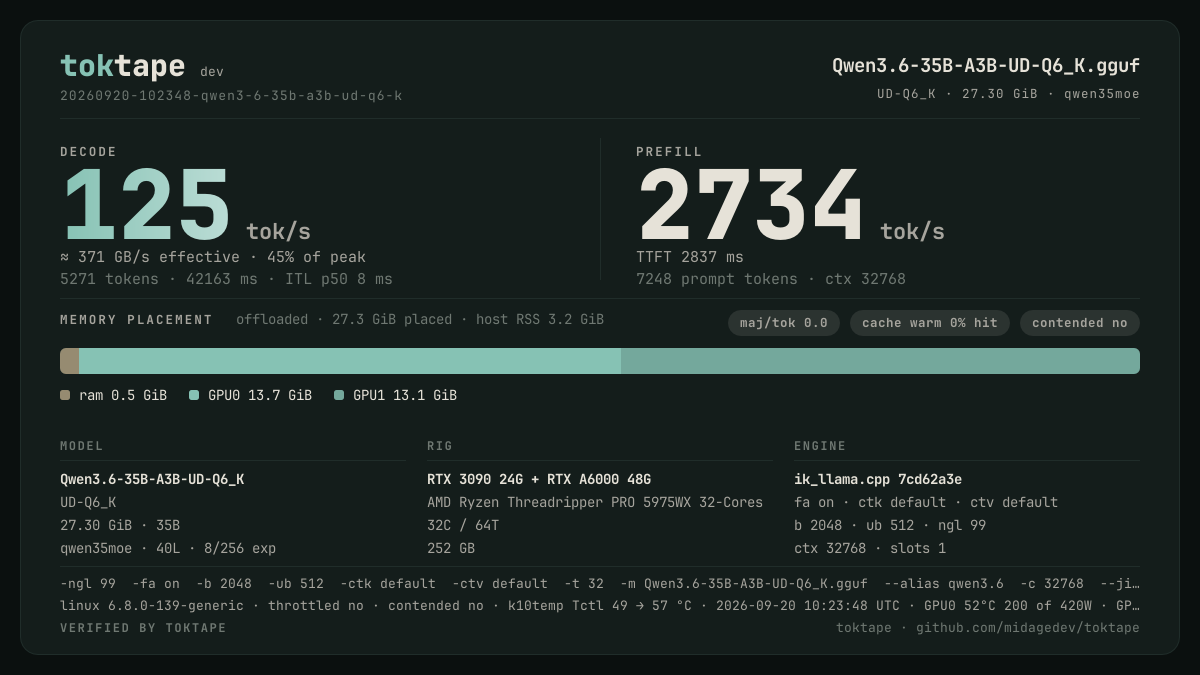
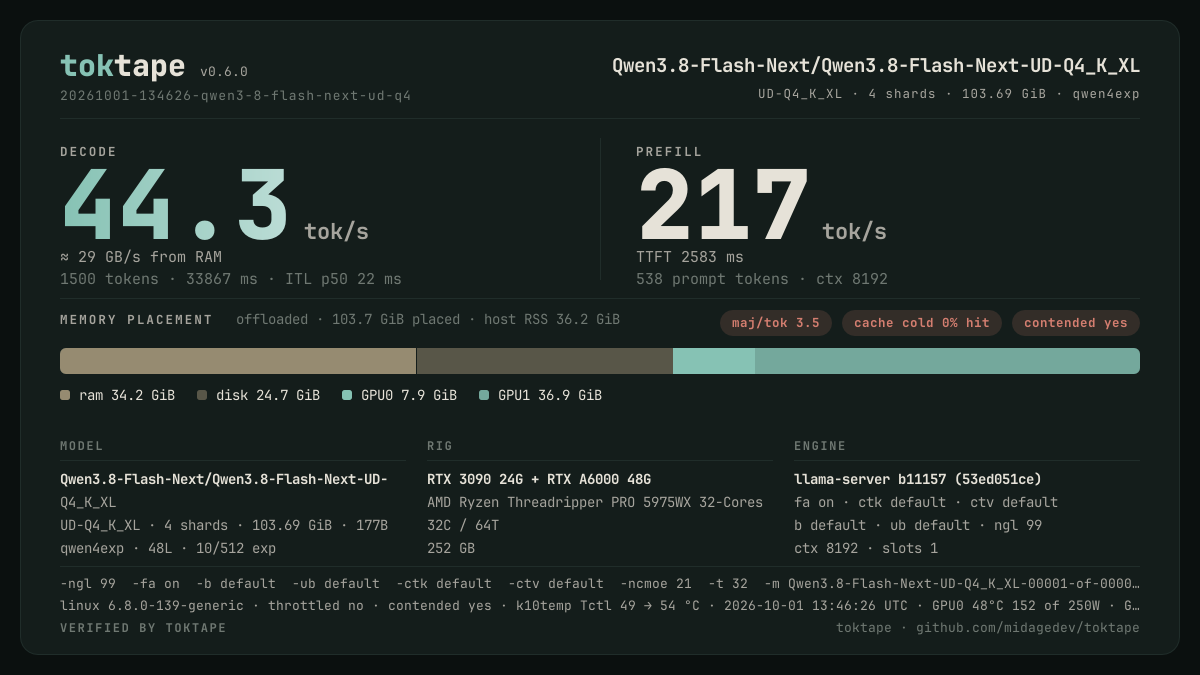
llama.cpp · Qwen3.8 Flash Next UD-Q4_K_XL · A6000 + 3090 · coding review 538 in / 1500 out · -ncmoe 21, no draft
44.3 tok/sprefill 217 tok/s
Qwen3.8-Flash-Next-UD-Q4_K_XL-00001-of-00004.gguf
llama-serverb11157UD-Q4_K_XL177B · 10B activeP538 · G1500 · cache 0%ctx 8kfa onoffload partialrtx-3090rtx-a6000linux1 stream! 2 caveats
2026-10-01