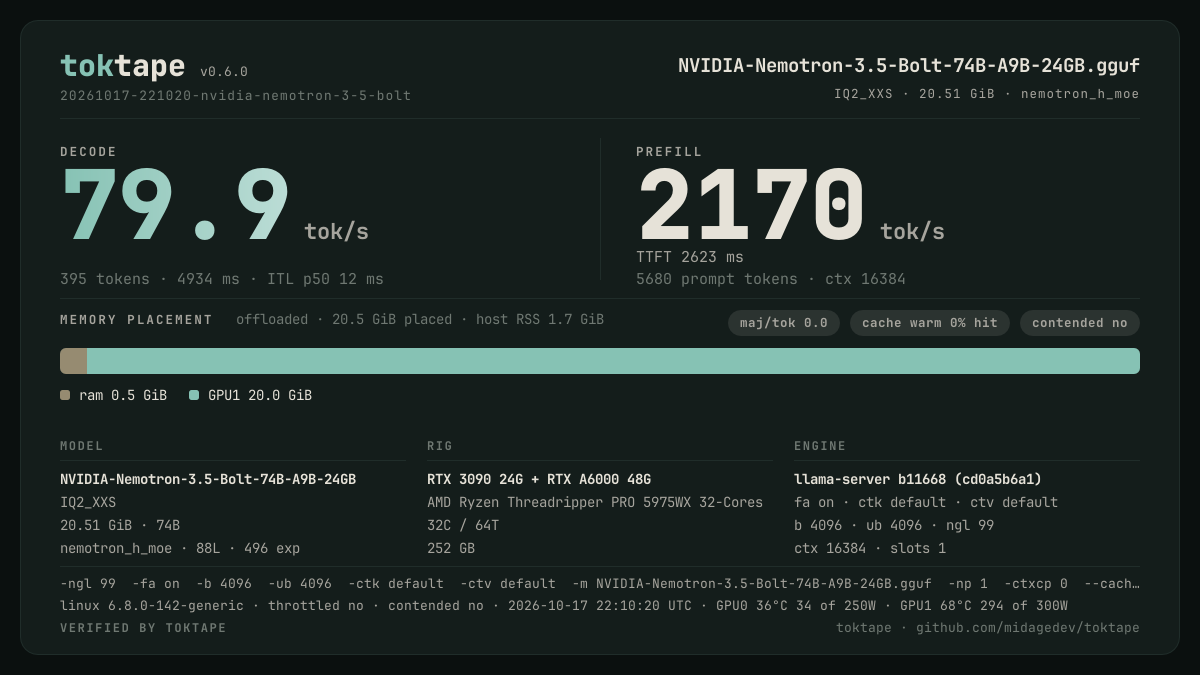
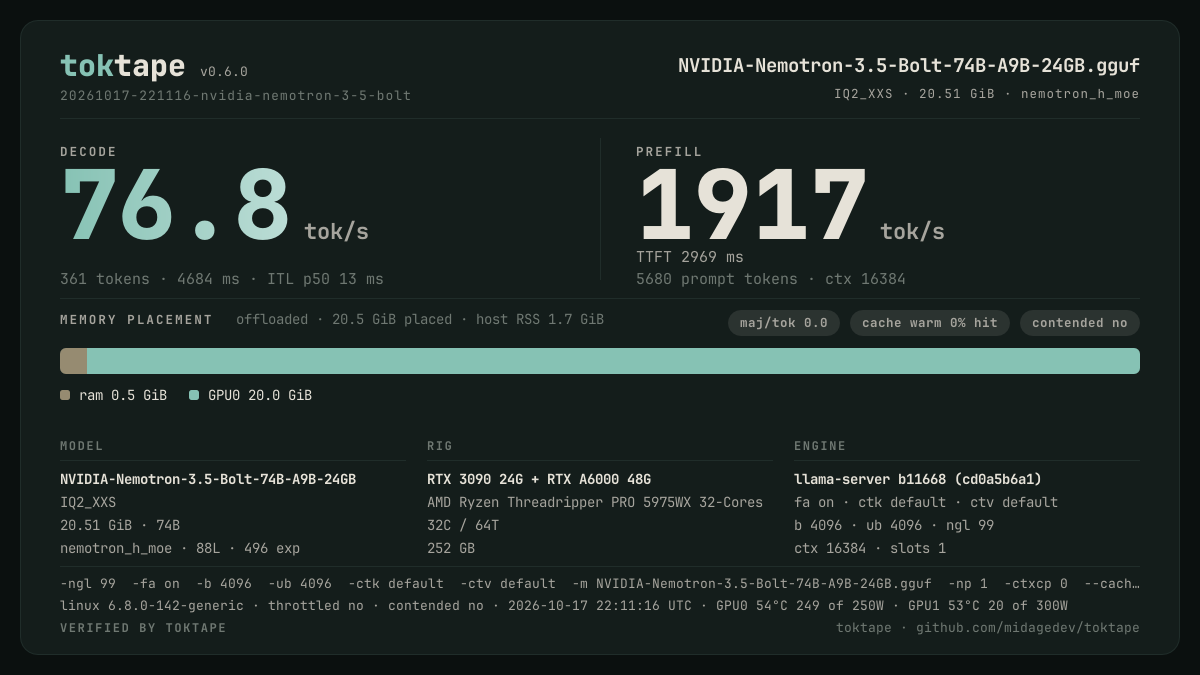
llama.cpp llama-server · Nemotron 3.5 Bolt 74B-A9B · RTX 3090 alone · 5.7K-token prompt
76.8 tok/sprefill 1917 tok/s
hf-packed-345x8.1b
llama-serverb11668IQ2_XXS74B · 72B activeP5680 · G361 · cache 0%ctx 16kfa onrtx-3090rtx-a6000linux1 stream! 2 caveats
2026-10-17